Nell'articolo su prompt, context, loop e graph engineering ho lasciato fuori volutamente un pezzo, perché merita spazio suo: il modo in cui progetti i tool che dai in mano a un agente. È una delle cause più comuni — e più sottovalutate — di agenti che sembrano funzionare in demo e falliscono in produzione.
Il bug che non sembra un bug
Il pattern è sempre lo stesso, e l'ho visto ripetersi anche nei miei progetti: l'agente chiama il tool giusto, al momento giusto, ma con l'input sbagliato. Non è un errore che si vede subito. Nei log la chiamata ha successo, la risposta è grammaticalmente corretta, tutto sembra andare. Il problema è che il risultato è plausibile e silenziosamente sbagliato — magari un tool di ricerca che riceve l'intera domanda dell'utente, preamboli e ringraziamenti finali inclusi, invece della query pulita che si aspettava.
Il modello, in questi casi, ha fatto esattamente quello che la descrizione del tool gli diceva di fare. Il problema non è nel modello: è in una descrizione da una riga che dice "cerca nella documentazione" senza mai specificare che formato deve avere l'input.
I tool sono un'API pubblica per il modello
Il modo più utile di pensare a un tool è trattarlo come un'API pubblica rivolta a un consumatore particolare: un modello che ha letto la documentazione una volta sola, non può fare domande di chiarimento, e deve decidere in un istante se e come usarlo sulla base di quello che legge nella descrizione.
Questo cambia completamente l'approccio alla scrittura. La descrizione di un tool non è documentazione per uno sviluppatore che la può rileggere con calma: viene iniettata direttamente nel contesto dell'agente e guida in modo diretto il suo ragionamento. Scrivere una descrizione di tool è, a tutti gli effetti, un lavoro di prompt engineering — solo che l'errore, qui, non produce una risposta storta in una conversazione, produce un'azione sbagliata nel mondo reale.
Una descrizione efficace dovrebbe rispondere sempre a tre domande, perché sono esattamente quelle che un agente valuta al momento di scegliere quale tool usare: cosa fa questo tool, quando va usato, e cosa restituisce.
Meno tool, ma inequivocabili
Un errore comune, soprattutto quando un sistema cresce, è aggiungere tool su tool senza mai fermarsi a chiedersi se si sovrappongono. Il principio utile qui è semplice da enunciare e facile da dimenticare: se uno sviluppatore umano non saprebbe dire con certezza quale dei due tool usare in una data situazione, non si può pretendere che lo sappia un agente. Gli agenti scelgono i tool confrontando le descrizioni, e ogni sovrapposizione tra due tool simili è una fonte diretta di errori di selezione.
La soluzione, quando succede, non è quasi mai aggiungere ancora più dettaglio alle descrizioni per distinguerli. È consolidare: ridurre il numero di tool fino a quando ognuno ha uno scopo inequivocabile, anche se questo significa che un singolo tool fa un po' più lavoro di quanto avresti fatto istintivamente in fase di progettazione.
Schema, default e messaggi d'errore che si possono recuperare
Oltre alla descrizione, ci sono tre altri livelli dove si gioca l'affidabilità di un tool:
Lo schema dei parametri deve essere il più restrittivo possibile senza diventare inutilizzabile — tipi precisi, enum quando le opzioni sono un insieme chiuso, formati espliciti per date e query, invece di lasciare che sia il modello a indovinare la forma giusta dell'input.
I valori di default contano più di quanto sembri. Un parametro opzionale con un default sensato riduce drasticamente le occasioni in cui l'agente deve inventarsi un valore, e ogni valore inventato è un'occasione in più di sbagliare.
I messaggi di errore dovrebbero essere scritti pensando a chi li leggerà davvero: non uno sviluppatore in un log, ma il modello stesso, nello stesso turno del loop in cui l'errore si è verificato. Un errore generico tipo "richiesta fallita" non dà al modello nessuna informazione utile per correggersi. Un errore che spiega cosa era sbagliato nell'input, e come dovrebbe essere strutturato invece, permette all'agente di correggere il tiro al tentativo successivo invece di ripetere lo stesso errore in loop — il che ci riporta dritti al problema di loop engineering di cui ho parlato nell'articolo precedente.
Perché rompe tutto il loop, non solo quella chiamata
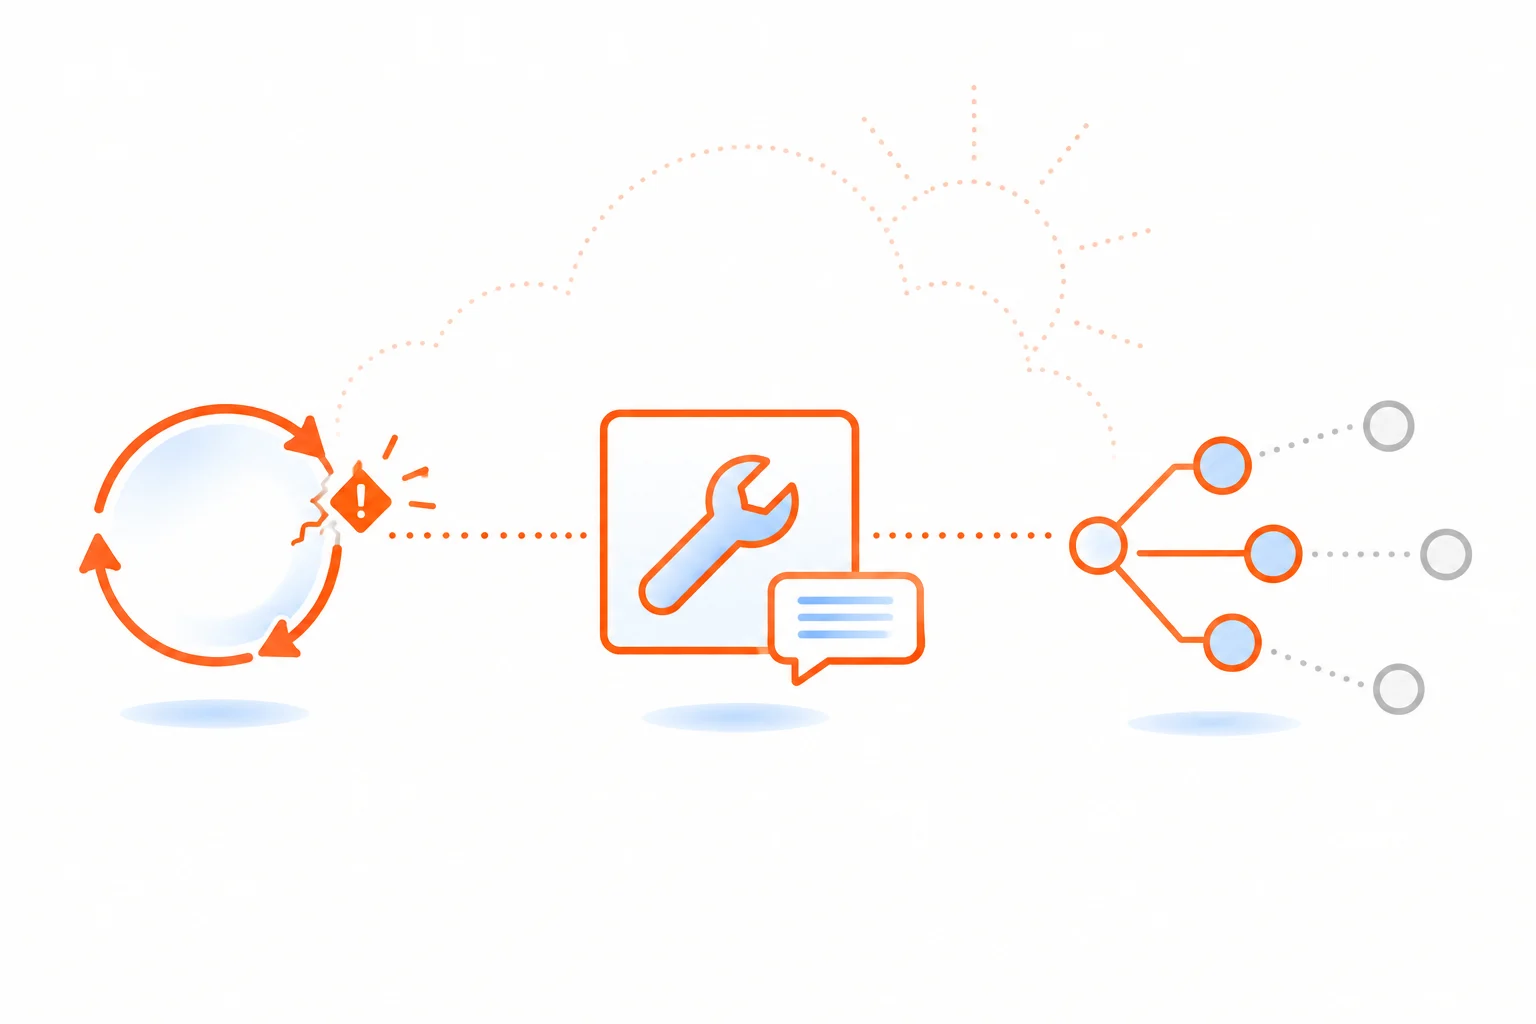
Qui si chiude il cerchio con gli altri livelli di questa serie. Un tool mal descritto non produce solo un output sbagliato isolato: inquina lo stato che l'agente porta con sé nel passo successivo del loop. Se il tool restituisce dati nel formato sbagliato, o l'agente lo chiama con l'input sbagliato senza accorgersene, tutto quello che viene dopo in quel ciclo — la decisione successiva, l'eventuale secondo tool chiamato sulla base del primo risultato, la risposta finale all'utente — eredita quell'errore silenziosamente.
In un sistema con più agenti orchestrati come un grafo, il danno si propaga ancora più lontano: un tool difettoso in un nodo può portare il flusso verso il ramo sbagliato dell'intero grafo, molto oltre il punto in cui l'errore è stato commesso.
È lo stesso principio per cui, nell'articolo su perché l'AI ti suggerisce sempre lo stesso stack, insisto sul ragionare prima di implementare: un tool, come un'intera architettura, va progettato pensando ai vincoli reali del sistema, non aggiunto per abitudine o lasciato con la prima descrizione che sembrava andare bene.
È per questo che, quando qualcosa in un agente non funziona come dovrebbe, la prima cosa che controllo non è quasi mai il prompt di sistema. È la descrizione dei tool che gli ho dato in mano.