Per due anni "prompt engineering" è stata la parola d'ordine di corsi e post LinkedIn. Intanto chi mette sistemi AI in produzione lavora su altro: cosa vede il modello, come gira il ciclo, come si passano il lavoro più agenti. In questo pezzo separo le quattro competenze, perché non sono versioni upgrade l'una dell'altra.
Prompt engineering: la base, non il traguardo
La prompt engineering è quello che tutti immaginano: scrivere l'istruzione giusta per ottenere la risposta giusta da un modello. Few-shot examples, chain-of-thought, ruoli assegnati al modello ("agisci come..."), formati di output specificati con precisione.
Resta utile, ma pesa meno di prima. Il motivo è strutturale: i modelli di punta si sono avvicinati. Lo Stanford AI Index 2025 riporta che in un anno il distacco tra il primo e il decimo modello in classifica è sceso dall'11,9% al 5,4%, e i primi due sono separati dallo 0,7%. Quando i modelli si somigliano, il trucco di prompting smette di essere un vantaggio. Il vantaggio si sposta altrove.
Context engineering: quello che quasi nessuno insegna
Ecco il pezzo che manca in molte conversazioni sull'argomento, incluse spesso le mie prime bozze mentali su questi temi: la context engineering.
Non è scrivere un'istruzione migliore. È decidere cosa il modello vede prima di rispondere: quali dati recuperare, in che formato e ordine, quali tool rendere disponibili, quanta cronologia tenere, cosa tagliare perché rumore. Anthropic la descrive come la naturale evoluzione della prompt engineering, in Effective context engineering for AI agents: l'obiettivo è il più piccolo insieme di token ad alto segnale.
Il punto controintuitivo: più contesto non vuol dire risultati migliori. Anthropic chiama "context rot" il calo con cui, al crescere dei token nella finestra, il modello richiama peggio le informazioni. C'è anche il conto. Per token l'output costa di più: nel listino Claude Sonnet 4.5 sta a 3 dollari per milione in input e 15 in output. Ma un agente rimanda tutto il contesto a ogni giro, e lì l'input diventa la voce che pesa. Ne ho parlato in prompt caching nelle API LLM.
Fare context engineering bene vuol dire, in pratica: costruire pipeline di retrieval che portano solo l'informazione rilevante, strutturare quella informazione in un formato che il modello può usare senza doverlo reinterpretare, decidere esplicitamente cosa "dimenticare" da una conversazione lunga, e definire con precisione quali tool il modello ha a disposizione in quel momento — non tutti quelli che esistono nel sistema. Anche i file di regole per gli agenti di coding sono context engineering in piccolo: AGENTS.md, CLAUDE.md e regole Cursor decidono cosa l'agente sa prima ancora del primo prompt.
Loop engineering: il ciclo che fa di un prompt un agente
Un prompt singolo produce una risposta singola. Un agente, invece, ragiona in cicli: osserva lo stato attuale, decide un'azione, la esegue, osserva il risultato, decide il passo successivo — e ripete finché il compito non è concluso o finché non viene interrotto.
Progettare bene questo ciclo è un lavoro a sé. Vuol dire decidere quando il loop deve fermarsi (condizioni di uscita chiare, non "fino a quando sembra finito"), come gestire un errore in un singolo step senza far collassare l'intero processo, quanti tentativi concedere prima di passare la palla a un umano, e come evitare che il modello giri in tondo ripetendo la stessa azione senza avvicinarsi alla soluzione — un problema molto più comune di quanto sembri quando si costruiscono agenti reali.
Un loop mal progettato è il motivo per cui molti "agenti AI" dimostrativi funzionano benissimo nel video di presentazione e si bloccano al primo caso limite in produzione.
Uno dei punti dove i loop si rompono più spesso sono i tool: ne ho scritto in Tool engineering. E prima di progettare un loop vale la domanda opposta: quando un agente non serve.
Graph engineering: quando un solo loop non basta
Man mano che un sistema cresce, un singolo ciclo agente-azione-osservazione smette di bastare. Compiti diversi richiedono agenti diversi con responsabilità diverse: uno che pianifica, uno che esegue ricerche, uno che scrive codice, uno che verifica il risultato finale. A quel punto il problema diventa orchestrare più agenti che si passano lavoro tra loro, in un flusso che spesso non è lineare ma si ramifica, si unisce di nuovo, torna indietro quando qualcosa fallisce.
Qui entra la graph engineering: modellare il sistema come un grafo di nodi (agenti, strumenti, punti di decisione) e archi (le condizioni che determinano dove va il flusso). È l'approccio dietro framework come LangGraph, ed è quello che sto approfondendo scrivendo il mio libro sui sistemi multi-agente. La differenza rispetto a un semplice loop è che il grafo permette percorsi condizionali espliciti — se l'agente di verifica trova un errore, il flusso torna all'agente che ha scritto il codice, non semplicemente al passo precedente in sequenza.
Come si incastrano tra loro
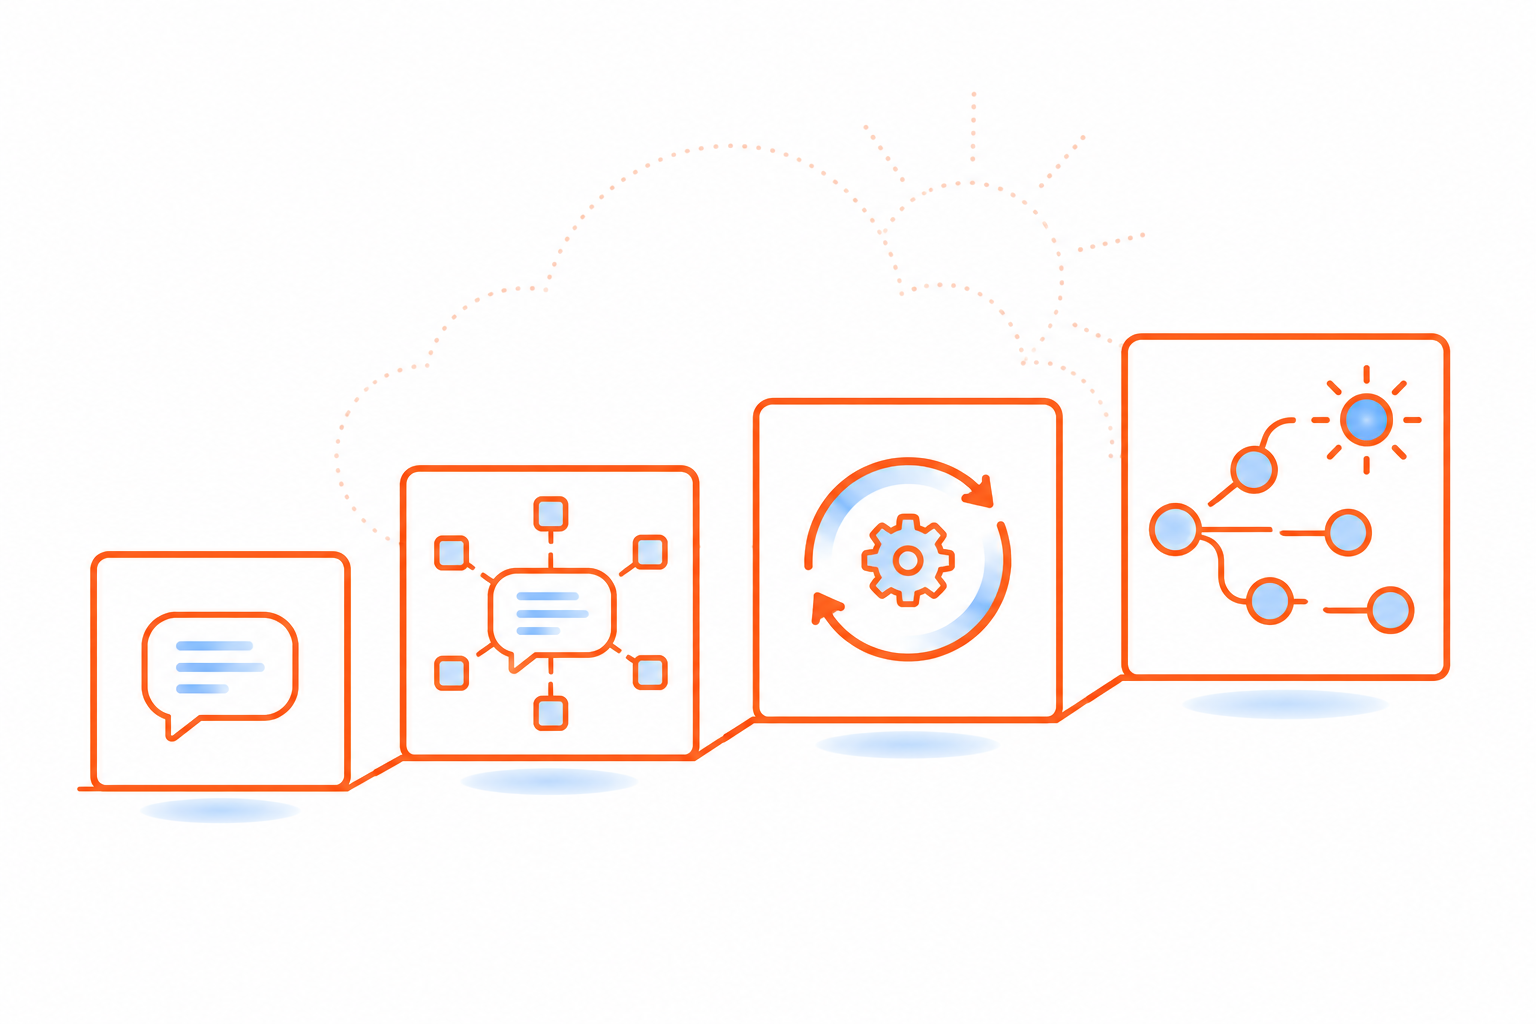
Non sono quattro fasi in sequenza né quattro livelli di uno stesso skill. Sono quattro competenze che si sommano, e servono contemporaneamente in progetti diversi:
- La prompt engineering resta la base per ogni singola interazione con un modello, dentro qualsiasi sistema più grande
- La context engineering decide cosa quel prompt ha davvero a disposizione per rispondere bene
- La loop engineering entra in gioco quando il compito richiede più passaggi autonomi di un singolo agente
- La graph engineering entra in gioco quando servono più agenti coordinati, con responsabilità e percorsi diversi
Chi si ferma alla prima usa solo una parte delle leve che ha. Il salto di qualità nei progetti AI che sto costruendo — e in quello che sto scrivendo nel libro — sta tutto in queste tre competenze successive, molto più che in un prompt scritto meglio.
Un esempio concreto
Per rendere tutto meno astratto, un caso tipico: un agente che gestisce il supporto clienti via email.
Prompt engineering. Chiedi al modello: "Rispondi a questa email di un cliente in modo professionale." Ottieni una risposta plausibile, ma il modello non sa nulla dello storico del cliente, delle policy aziendali, o se quel problema è già stato risolto altrove.
Context engineering. Prima di far rispondere il modello, costruisci il contesto: recuperi lo storico ticket di quel cliente da un database, la policy di reso rilevante da una knowledge base tramite RAG, e lo stato dell'ordine da un'API. Passi al modello solo questi pezzi, formattati in modo pulito — non l'intero database. La risposta ora è specifica e accurata, non generica.
Loop engineering. Il compito non finisce con una risposta: l'agente deve osservare l'email, decidere se serve un rimborso, eseguire la chiamata API al sistema di pagamento, verificare che sia andata a buon fine, e solo allora rispondere al cliente. Se l'API fallisce, il loop deve ritentare un numero limitato di volte prima di passare il caso a un operatore umano — altrimenti rischi un loop infinito o un rimborso duplicato.
Graph engineering. Ora immagina ticket di tipo diverso: reso, bug tecnico, domanda commerciale. Costruisci un grafo con un nodo "triage" che smista il ticket, un nodo "reso" con accesso al sistema pagamenti, un nodo "supporto tecnico" con accesso alla knowledge base di prodotto, e un nodo "verifica finale" che controlla la qualità della risposta prima dell'invio — con un arco che torna indietro al nodo giusto se la verifica non passa.
Lo stesso compito, quattro livelli di ingegnerizzazione, quattro risultati completamente diversi in termini di affidabilità.
Se vuoi far girare questi loop sulla tua macchina invece che in cloud, la Guida AI locale parte da quando conviene davvero. Tutti i pezzi su questi temi sono nell'hub AI Engineering.
Domande frequenti
01Che differenza c'è tra prompt engineering e context engineering?
La prompt engineering cura l'istruzione: come chiedi. La context engineering cura tutto quello che il modello vede quando risponde: dati recuperati, tool disponibili, cronologia, regole di progetto. Il prompt è una parte del contesto, non il tutto.
02Più contesto dà risposte migliori?
No. Oltre un certo punto il modello richiama peggio le informazioni, un effetto che Anthropic chiama context rot. Conviene passare il minimo di informazioni ad alto segnale, non tutto quello che hai.
03Quando serve la graph engineering invece di un singolo loop?
Quando compiti diversi chiedono agenti con responsabilità e strumenti diversi, e il flusso ha rami condizionali: triage, esecuzione, verifica che rimanda indietro se qualcosa non torna. Se un solo agente con un ciclo chiaro basta, il grafo è complessità in più.
04La prompt engineering serve ancora?
Sì, resta la base di ogni singola chiamata al modello. Pesa meno come vantaggio competitivo perché i modelli di punta si sono avvicinati e i trucchi funzionano in modo simile su tutti.