Questo pezzo è per chi chiama già un modello da un'app o da un agente e si accorge che non sa quanto spende, cosa manda e quante volte ripete la stessa domanda. Vive nell'hub AI Engineering e segue il pezzo sulla Web Search API di Cloudflare: lì davi strumenti all'agente, qui metti un controllo davanti alle sue chiamate.
In breve: AI Gateway è un proxy di Cloudflare tra il tuo codice e il provider del modello. Cambi l'URL di base del client e ottieni tre leve. I log, con la possibilità di salvare solo i metadati e non i prompt. La cache, che è disattivata di default e lavora per corrispondenza esatta: non è il prompt caching del provider. E gli spend limit, budget in dollari che rispondono 429 quando li superi. Nessuna delle tre è magia: ognuna ha un limite che conviene conoscere prima.
Cosa fa AI Gateway, in una frase
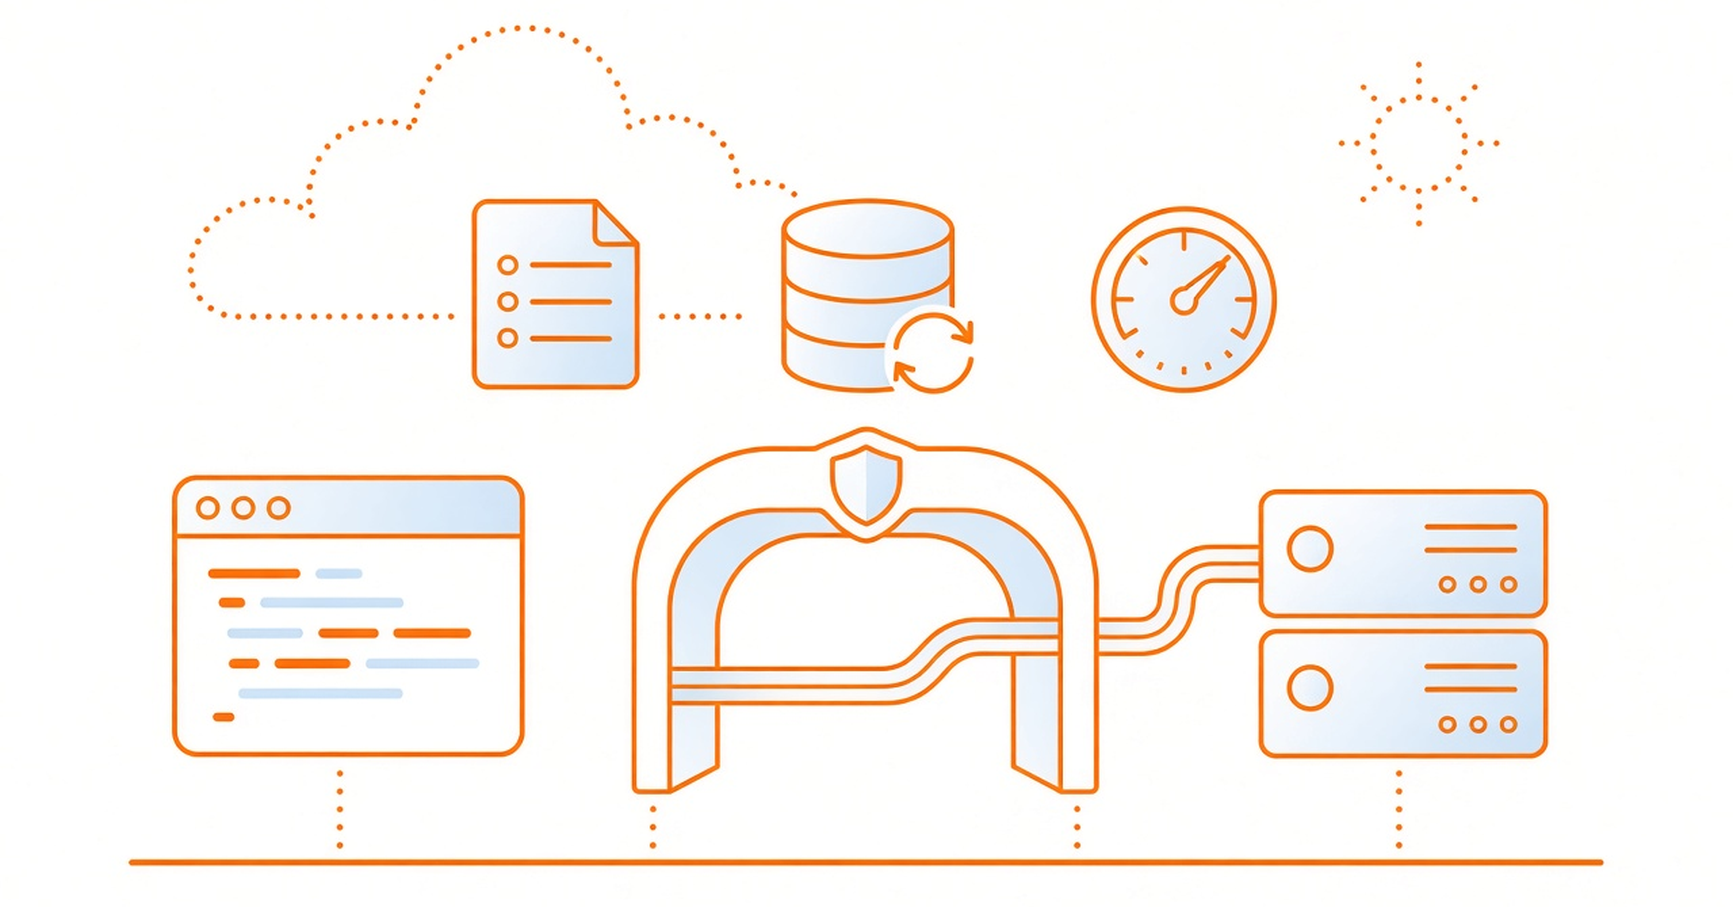
AI Gateway è un proxy gestito da Cloudflare che riceve le chiamate ai modelli (OpenAI, Anthropic, Workers AI e altri provider), le inoltra e intanto registra log, applica cache, limiti di frequenza e di spesa.
La domanda giusta non è "mi serve un gateway?". È: quando la bolletta o un prompt finito nel posto sbagliato mi faranno male, voglio scoprirlo da un log o da una mail del provider?
Secondo la pagina dei prezzi, le funzioni base (analytics, cache, rate limiting) sono gratuite su tutti i piani. I log seguono regole diverse, ci arriviamo sotto.
Il collegamento: cambia l'URL, non il client
Se usi l'SDK di OpenAI, il passaggio è lo stesso visto per i runtime locali OpenAI-compatible: cambi base_url e lasci il resto. L'URL del gateway contiene account, nome del gateway e provider.
import os
from openai import OpenAI

ACCOUNT = os.environ["CF_ACCOUNT_ID"]
GATEWAY = os.environ.get("CF_GATEWAY_ID", "default")

client = OpenAI(
    api_key=os.environ["OPENAI_API_KEY"],  # la chiave del provider, come prima
    base_url=f"https://gateway.ai.cloudflare.com/v1/{ACCOUNT}/{GATEWAY}/openai",
)
Due dettagli dalla documentazione. Dal changelog di marzo 2026, se usi default come nome del gateway, Cloudflare lo crea alla prima richiesta. E da maggio 2026 esiste anche una REST API unificata su api.cloudflare.com, con endpoint compatibili con OpenAI e Anthropic e fatturazione unica. Sono due strade: la prima tiene le tue chiavi dei provider, la seconda passa dalla fatturazione Cloudflare.
Come sempre, account, gateway e chiave stanno in variabili d'ambiente. Così togli il gateway, o lo cambi, senza toccare il codice.
Log: decidi cosa salvi prima di accenderli
Il log è la prima cosa che vedi e quella con più conseguenze. Per default AI Gateway salva richiesta e risposta complete insieme ai metadati.
Se nei prompt passano dati di utenti, il default è la scelta sbagliata. Il changelog del 17 marzo 2026 introduce l'header cf-aig-collect-log-payload: impostato a false, il gateway registra modello, provider, token, stato, costo e durata, ma non il contenuto. Hai i numeri senza conservare i testi.
Per spegnere del tutto il log di una singola richiesta c'è cf-aig-collect-log. Utile per le chiamate di test o per i flussi che non devono lasciare traccia.
Poi i metadati. Con l'header cf-aig-metadata (una stringa JSON) puoi etichettare ogni chiamata con app, utente o ambiente, e filtrare i log su quei campi. La documentazione sui metadati mette tre paletti: al massimo cinque voci per richiesta (le altre vengono ignorate), solo stringhe, numeri o booleani, e le chiavi che iniziano con cf. sono riservate.
r = client.chat.completions.create(
    model="gpt-4o-mini",
    messages=[{"role": "user", "content": "Riassumi il ticket"}],
    extra_headers={
        "cf-aig-collect-log-payload": "false",
        "cf-aig-metadata": '{"app": "supporto", "env": "prod", "user": "u_123"}',
    },
)
Un'ultima cosa sui log, recente. Le pagine dei limiti e dei prezzi distinguono chi ha creato il primo gateway prima del 24 settembre 2026, che resta sui log "legacy" con tetti fissi (100.000 log per account sul piano free), da chi lo crea dopo, che segue limiti e prezzi di Workers Logs. Se apri un account adesso, leggi quella pagina prima di lasciare il log acceso su tutto.
Cache: utile, ma solo per richieste identiche
La cache è la leva che sembra regalare soldi. Va capita bene, perché è più stretta di quanto sembri.
Primo: è disattivata di default. La attivi nelle impostazioni del gateway oppure richiesta per richiesta.
Secondo: la chiave di cache è un hash di provider, endpoint, modello, header di autenticazione e corpo completo della richiesta. Lo dice la documentazione sulla cache. Basta una temperature diversa, un timestamp nel prompt di sistema o un tool in più e la richiesta è nuova. Anche due chiavi API diverse non condividono la cache.
Quindi la cache serve dove le richieste si ripetono davvero uguali: FAQ, classificazioni di testi fissi, prompt di valutazione rilanciati sugli stessi casi. In una chat con lo storico che cresce a ogni messaggio, aspettati pochi hit.
AI Gateway fa prompt caching? No. La cache del gateway salva la risposta a una richiesta identica e la restituisce senza chiamare il modello. Il prompt caching è un'altra cosa e lo fa il provider (Anthropic, OpenAI, Gemini): il modello viene chiamato sempre, ma il prefisso del prompt che resta uguale, come istruzioni di sistema, tool e storico, costa meno e risponde prima. Le due leve lavorano a livelli diversi: una richiesta che non trova la risposta nella cache del gateway arriva al provider, e lì può valere il suo prompt caching. Per la chat con lo storico che cresce, la leva giusta è la seconda. Come si attiva e quanto costa per ciascun provider è in Prompt caching nelle API LLM: Anthropic, OpenAI e Gemini a confronto.
Header | Cosa fa |
|---|---|
| durata in secondi, da 60 secondi a un mese |
| salta la cache per questa richiesta |
| chiave personalizzata, per raggruppare richieste equivalenti |
| header di risposta: |
La chiave personalizzata è potente e pericolosa allo stesso modo. Se due richieste con risposte diverse finiscono sotto la stessa chiave, una riceve la risposta dell'altra. Usala solo per richieste che danno davvero la stessa risposta.
Un caso in cui non accenderla: la stessa documentazione sconsiglia la cache sul gateway collegato ad AI Search, perché embedding serviti dalla cache possono degradare l'indice in silenzio. Il ragionamento vale anche per i tuoi embedding: se alimentano un indice, meglio non servirli dalla cache.
Tetto di spesa: spend limit, non solo rate limit
Il rate limiting conta le richieste. Non ti protegge da poche richieste molto costose, per esempio un agente in loop su un modello grande con contesto lungo. Per questo, da giugno 2026, ci sono gli spend limit: budget in dollari su una finestra di tempo, fissa o scorrevole.
Ogni regola si può limitare per modello, per provider o per un campo dei metadati. È qui che i metadati di prima tornano utili: con user nella richiesta puoi dare un budget per utente, oltre a un tetto totale sul gateway.
Quando il budget è finito, il gateway risponde 429 finché la finestra non si azzera. In alternativa puoi passare a un modello più economico tramite le rotte dinamiche invece di bloccare.
Una distinzione utile: rate limiting e spend limit del gateway proteggono le chiamate al modello. Per limitare le richieste che gli utenti fanno alla tua app, prima che arrivino al modello, su Workers ci sono il binding di rate limiting, le regole WAF e i Durable Objects. Le tre strade a confronto sono in Rate limiting su Cloudflare Workers.
Tre limiti scritti nella documentazione, da tenere a mente:
- Consistenza eventuale. Il costo di una richiesta si registra quando finisce. Una raffica di richieste in parallelo può sforare il budget prima che il blocco scatti.
- Stima, non fattura. Il costo è calcolato da token e listino del modello. Per la cifra esatta fa fede la dashboard del provider.
- Venti regole per gateway. Bastano per un tetto globale, qualche modello e qualche gruppo di utenti, non per regole per ogni cliente.
Quindi lo spend limit non sostituisce il limite di spesa del provider. È il primo freno, più vicino al codice. Il secondo, quello duro, resta impostato nell'account del provider.
Il 429 va gestito nel codice
Un tetto che blocca è utile solo se l'app sa cosa fare quando scatta. Il 429 dello spend limit è lo stesso codice di un rate limit del provider, e molti client lo trattano come errore temporaneo da ritentare.
L'SDK di OpenAI, per esempio, ritenta in automatico alcuni errori, 429 compreso. Contro un budget esaurito quei tentativi sono solo attesa in più. Decidi tu il comportamento: messaggio chiaro all'utente, coda per dopo, oppure passaggio a un modello più piccolo. È lo stesso principio del pezzo sugli agenti che non servono: il caso di errore va scritto, non lasciato al retry.
Una configurazione minima da cui partire
Per un progetto piccolo, l'ordine che ha senso è questo:
- Gateway dedicato per ambiente: uno per prod e uno per sviluppo, così log e budget non si mescolano.
- Log solo metadati in prod:
cf-aig-collect-log-payload: falsedove passano dati di utenti, log completo in sviluppo. - Metadati coerenti: tre o quattro campi fissi (
app,env,user, magarifeature), sempre gli stessi. - Spend limit globale sul gateway di prod, più uno per utente se l'app è aperta al pubblico.
- Cache solo dove serve: accesa per singola richiesta sui flussi ripetitivi, non globale.
- Gestione del
429nel client, con un test che la verifichi.
Cosa conviene fare adesso
Se chiami già un modello da un'app, crea un gateway, punta il client al suo URL e accendi solo i log con metadati. Lascia girare qualche giorno: i numeri ti diranno se serve la cache e quanto deve essere alto il budget. Poi aggiungi lo spend limit e scrivi la gestione del 429.
Se i tuoi agenti usano anche strumenti esterni, il pezzo sulla Web Search API è il complemento naturale. E se il modello gira sul tuo stack Workers, D1 e R2, il gateway è il pezzo che manca tra codice e fattura.
Domande frequenti
01AI Gateway sostituisce il limite di spesa del provider?
No. Lo spend limit di AI Gateway è una stima basata su token e listino, ed è eventualmente consistente. Tienilo come primo freno vicino al codice e lascia attivo anche il limite nell'account del provider.
02AI Gateway fa prompt caching?
No: la cache di AI Gateway restituisce la risposta salvata di una richiesta identica senza chiamare il modello, mentre il prompt caching è del provider, chiama sempre il modello e fa pagare meno la parte del prompt che si ripete.
03La cache di AI Gateway funziona con le chat?
Poco. La chiave di cache include il corpo completo della richiesta, quindi ogni messaggio nuovo nello storico crea una richiesta diversa. La cache rende su richieste ripetute identiche, come FAQ, classificazioni ed eval.
04Posso usare AI Gateway senza salvare i prompt?
Sì. L'header cf-aig-collect-log-payload: false registra solo metadati come modello, token, costo e durata, senza richiesta e risposta. Con cf-aig-collect-log puoi anche spegnere il log di una singola chiamata.